Coding-Agenten wie Claude Code oder Codex können aus einer Prozessskizze ein Prozessmodell erstellen, das sich in gängigen Modellierungswerkzeugen öffnen und bearbeiten lässt. Dieser Beitrag zeigt dazu zwei Versuche an einem Beispiel aus dem Kundenservice. Im ersten Versuch erstellt der Agent aus einem Whiteboard-Foto ein Prozessmodell. Im zweiten Versuch entwirft er denselben Prozess mit einem KI-Agenten neu.
Der zweite Entwurf enthält gute Ansätze, der Agent entscheidet darin aber kaum etwas selbst. Daraus ergibt sich die These dieses Beitrags: Die KI-Welt erfindet gerade das Prozessmanagement neu. Wer Prozesse modellieren kann, bringt das Handwerk mit, das beim Einsatz von KI-Agenten bisher fehlt.
Auf einen Blick
- Ein Coding-Agent macht aus einem Whiteboard-Foto ein editierbares Prozessmodell und entwirft den Prozess neu. Der Entwurf ist schnell da, bleibt aber ein Vorschlag, den die Fachabteilung prüfen muss.
- Ein Agent lohnt sich dort, wo erst ein Zwischenergebnis zeigt, was als Nächstes zu tun ist. Für alles andere reicht ein fester Workflow.
- Was feststehen muss, gehört ins Prozessmodell und nicht in den Prompt. Dafür hat das Prozessmanagement seit Jahren Notation und Handwerk.
- Die größeren Hürden liegen außerhalb des Modells: Der Engpass wandert zum nächsten Schritt, der gezeichnete Prozess ist nicht der gelebte, und ein Teil der Belegschaft nutzt KI bereits, ohne dass es sichtbar ist.
Der Fall: eine Anfrage im Kundenservice
Als Beispiel dient ein Lehrfall bei einem Zahlungsdienst. Der Fall ist vollständig erfunden.
Eine Kundin schreibt in den Chat (im Folgenden Ticket K-17):
„Mein Paket ist nie angekommen. Bitte erstatten. Ich habe doch 30 Tage Zeit.“
Für die Antwort benötigt der Kundenservice drei Quellen: den Chat, die Bestelldaten mit Sendungsverfolgung und die Käuferschutz-Richtlinie. Der Abgleich der Quellen zeigt zwei Unstimmigkeiten:
- Die Frist von 30 Tagen gilt nicht mehr. Seit dem Sommer sind es 21 Tage, damit kommt die Meldung drei Tage zu spät.
- Der Paketdienst meldet „zugestellt“. Es fehlt aber der Nachweis, dass die Kundin das Paket abgeholt hat.
Offen ist damit, welche Regel gilt und ob die Ware angekommen ist. Über die Erstattung entscheidet am Ende das Käuferschutz-Team.
Versuch 1: vom Whiteboard-Foto zum Prozessmodell
Der Coding-Agent (hier Claude Code) erhielt das Foto eines Whiteboards und einen Satz als Auftrag. Auf dem Whiteboard stehen einige Kästen, Pfeile und die Randnotiz „2-4 Tage ?!“. Die folgende Wiedergabe zeigt den aufgezeichneten Lauf.
Begriff: Coding-Agent
Ein Coding-Agent ist ein KI-Agent, der in einem Projektordner arbeitet: Er liest und schreibt Dateien, führt Befehle aus und prüft das Ergebnis. Beispiele sind Claude Code und Codex. Diese Werkzeuge wurden für die Softwareentwicklung gebaut. Sie eignen sich aber für alle Aufgaben, deren Ergebnis als Datei vorliegt, also auch für Prozessmodelle.
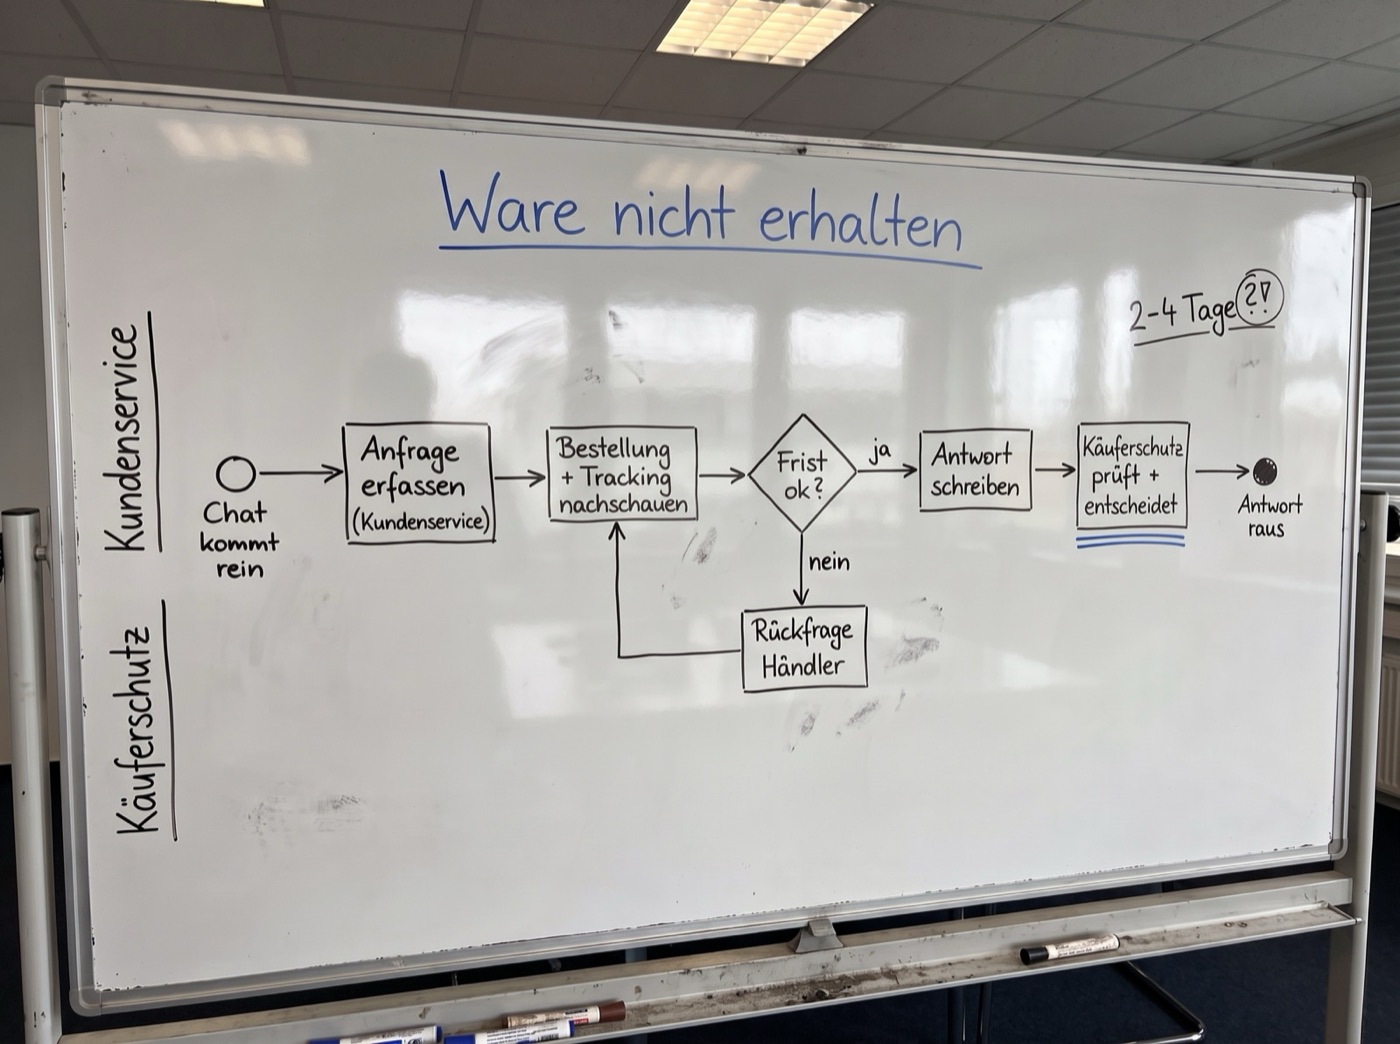
› Erstelle aus dem Foto input/whiteboard-skizze.jpg die Datei output/skizze.bpmn: ein BPMN-2.0-Modell mit Pool, den zwei Lanes, allen Schritten und dem Gateway mit beiden Pfaden. Übernimm die Beschriftungen wörtlich.

Ich lade zuerst den BPMN-Skill für die Konventionen und schaue mir dann die Skizze an.

▶ Skill prozessmodell-bpmn
  Launching skill: prozessmodell-bpmn

▶ Lesen input/whiteboard-skizze.jpg
  [Bild gelesen]

Skizze gelesen. Laut Projekt-CLAUDE.md führe ich keine Pipeline aus, sondern schreibe die beiden Dateien direkt, inklusive handgesetztem Layout.

▶ Schreiben output/skizze.bpmn  (197 Zeilen)
<?xml version="1.0" encoding="UTF-8"?>
<bpmn:definitions xmlns:bpmn="http://www.omg.org/spec/BPMN/20100524/MODEL"
                  xmlns:bpmndi="http://www.omg.org/spec/BPMN/20100524/DI"
                  xmlns:dc="http://www.omg.org/spec/DD/20100524/DC"
                  xmlns:di="http://www.omg.org/spec/DD/20100524/DI"
                  xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
                  id="Definitions_WareNichtErhalten"
                  targetNamespace="http://kirenz.de/bpmn/ware-nicht-erhalten"
                  exporter="handgeschrieben"
                  exporterVersion="1.0">

  <bpmn:collaboration id="Collaboration_1">
…

  Datei geschrieben

▶ Schreiben output/notizen.md  (3 Zeilen)
- Unklar: Der Schritt "Käuferschutz prüft + entscheidet" ist auf dem Whiteboard in der oberen Zeile (Kundenservice) gezeichnet, der Text nennt aber die Rolle Käuferschutz; ebenso ist nicht eindeutig, ob "Rückfrage Händler" wirklich vom Käuferschutz ausgeführt wird oder nur aus Platzgründen unten steht, und ob der Rückpfeil eine echte Schleife zurück zu "Bestellung + Tracking nachschauen" meint.
- Annahmen: "Käuferschutz prüft + entscheidet" und "Rückfrage Händler" liegen in der Lane Käuferschutz (Rollenname bzw. Position auf dem Board), der Zusatz "(Kundenservice)" unter "Anfrage erfassen" wurde als Lane-Zuordnung gelesen und nicht in den Task-Namen übernommen, der Rückpfeil ist als Schleife modelliert, alle Schritte sind userTasks (Menschen), das Gateway ist ein exklusives Gateway.
- Nicht übernommen: die Randnotiz "2-4 Tage ?!" oben rechts (Durchlaufzeit, Bezug unklar) sowie die blaue Unterstreichung unter "Käuferschutz prüft + entscheidet" (Hervorhebung ohne Prozessbedeutung).

  Datei geschrieben

Beide Dateien liegen in `output/`. Wie in der Projekt-CLAUDE.md verlangt, habe ich keine Befehle ausgeführt, die Validierung über die Process-Lab-Pipeline steht also noch aus.

**`output/skizze.bpmn`**
- Pool „Ware nicht erhalten" mit den Lanes „Kundenservice" und „Käuferschut …

✓ Fertig nach 98 Sekunden Laufzeit.
Zwei Stellen in der Mitschrift sind für die weitere Arbeit besonders wichtig:
- Der Agent lädt zuerst einen Skill, also eine hinterlegte Arbeitsanweisung für Prozessmodelle. Erst danach liest er das Foto.
- Der Agent schreibt neben dem Modell eine Notizdatei. Sie hält fest, was auf dem Whiteboard unklar war, welche Annahmen er getroffen hat und was er nicht übernommen hat (bspw. die Randnotiz „2-4 Tage ?!“).
Diese Notizen sind der Ausgangspunkt für die Prüfung durch das Prozessteam.
Begriff: Skill
Ein Skill ist eine wiederverwendbare Arbeitsanweisung für einen Agenten, abgelegt als Datei oder Ordner: Regeln, Beispiele und bei Bedarf Hilfsskripte für eine bestimmte Aufgabe. Der Agent lädt den Skill erst, wenn die Aufgabe ansteht. Im Lehrfall beschreibt der Skill, wie ein Prozessmodell aufgebaut und beschriftet wird. In der Mitschrift oben ist das der erste Schritt des Agenten („Skill prozessmodell-bpmn“).
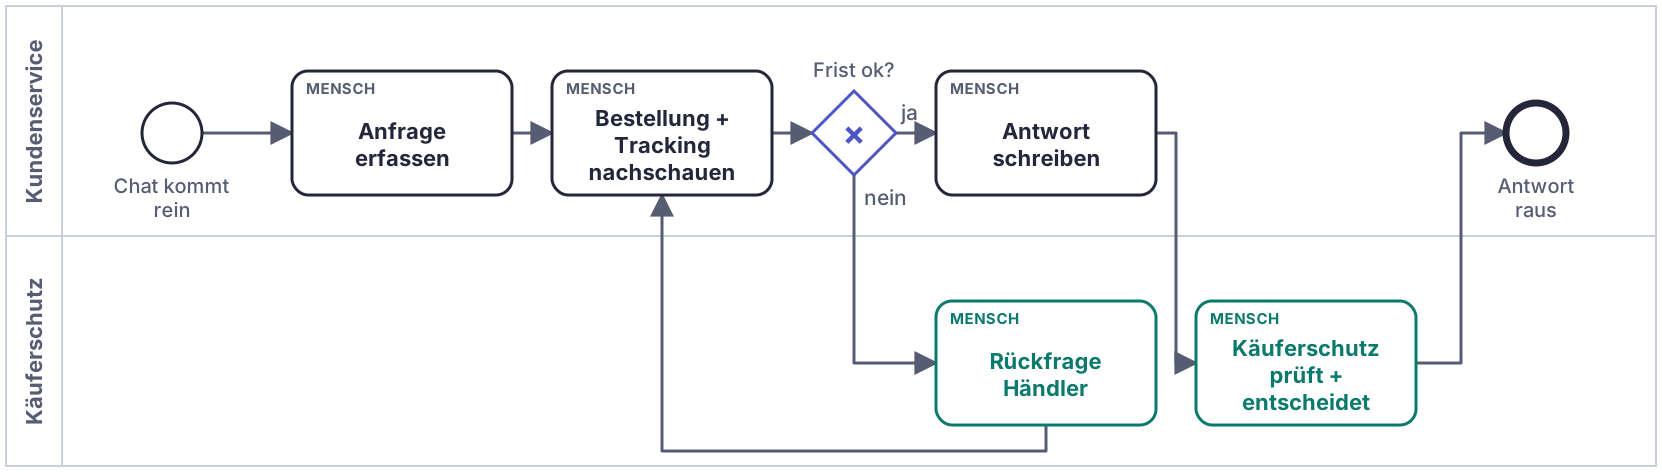
Die folgende Abbildung zeigt den heutigen Ablauf als Modell. Jede Bahn steht für eine Rolle, Kästen sind Aufgaben und Rauten sind Entscheidungen.
Begriff: BPMN
BPMN (Business Process Model and Notation) ist der verbreitete Standard, um Geschäftsprozesse zu zeichnen. Bahnen zeigen, wer zuständig ist. Kästen sind Aufgaben, Rauten sind Verzweigungen (Gateways), Kreise markieren Start und Ende. Hinter jeder Zeichnung liegt eine Datei, die Modellierungswerkzeuge lesen und bearbeiten können.
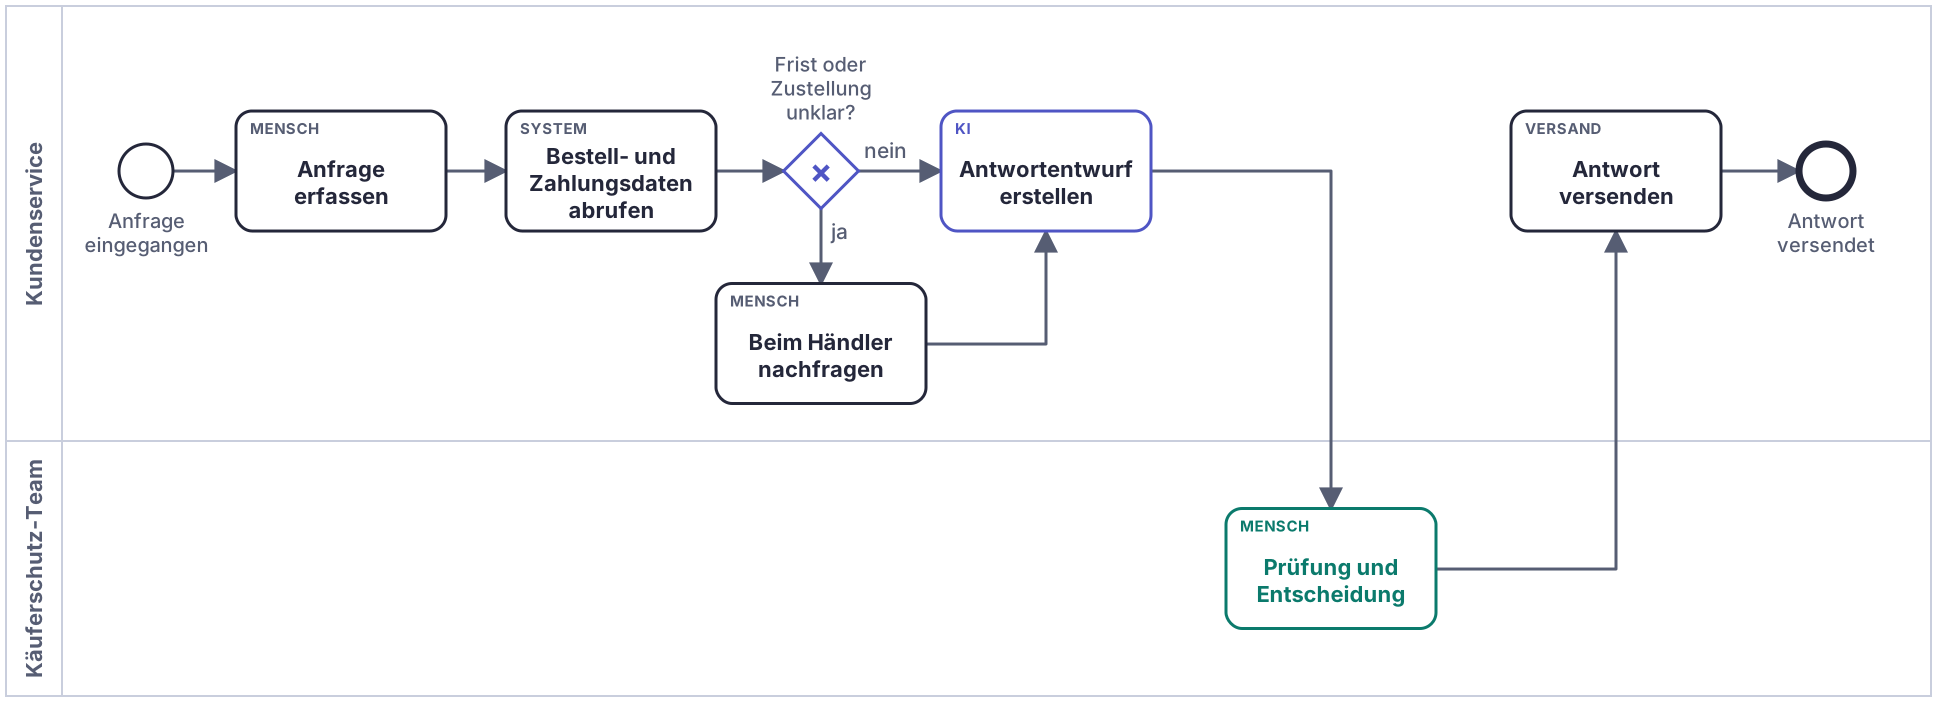
Vorher. Fast die gesamte Arbeit liegt in der oberen Bahn. Der Kundenservice erfasst die Anfrage, ruft Daten ab und fragt bei unklarer Frist oder Zustellung von Hand beim Händler nach. KI schreibt nur den Antwortentwurf. Erst danach wechselt der Fall in die untere Bahn, wo das Käuferschutz-Team noch einmal prüft und entscheidet. Im Lehrfall sind dafür zwei bis vier Arbeitstage angenommen, davon ein bis zwei Tage Wartezeit auf den Händler. Darstellung vereinfacht: Aufgabentyp als Beschriftung statt BPMN-Symbol.
Das Ergebnis ist eine Datei im offenen Standard BPMN 2.0 und damit mehr als ein Bild. Die Datei lässt sich in Camunda Modeler, SAP Signavio oder bpmn.io öffnen. Fachleute können dort jeden Schritt, jede Zuordnung und jede Rückschleife ändern.
<bpmn:lane id="Lane_Agent" name="KI-Agent">
  <bpmn:flowNodeRef>T_Haendler</bpmn:flowNodeRef>
  <bpmn:flowNodeRef>T_Dossier</bpmn:flowNodeRef>
</bpmn:lane>
…
<bpmn:businessRuleTask id="T_Regeln"
    name="Richtlinie, Frist und Nachweis prüfen">
  <bpmn:documentation>Feste Regel ohne Modell.
    Wählt die aktuelle Richtlinienversion …</bpmn:documentation>
</bpmn:businessRuleTask>
<bpmn:userTask id="T_Freigabe"
    name="Dossier prüfen und Freigabe erteilen">
  <bpmn:documentation>… Nur das Käuferschutz-Team
    entscheidet (Regel R5) …</bpmn:documentation>
</bpmn:userTask>
…
<bpmndi:BPMNShape bpmnElement="T_Regeln">
  <dc:Bounds x="540" y="40" width="160" height="80" />
</bpmndi:BPMNShape>
- Offener Standardöffnen und weiterbearbeiten in Camunda Modeler, SAP Signavio oder bpmn.io
Der Agent beschleunigt damit das Zeichnen. Ob der Ablauf so stimmt, müssen die Beteiligten weiterhin gemeinsam klären.
Versuch 2: den Prozess neu entwerfen
Für den Neuentwurf erhielt der Coding-Agent drei Dinge:
- Wissen: die Käuferschutz-Richtlinie und die Regeln des Käuferschutz-Teams.
- Arbeitsanweisung: denselben Skill wie im ersten Versuch.
- Vorgaben: Über Erstattung und Kulanz entscheidet nur das Käuferschutz-Team. Keine Nachricht versenden, keine Zahlung ändern.
Nach gut zwei Minuten lag der folgende Entwurf vor:
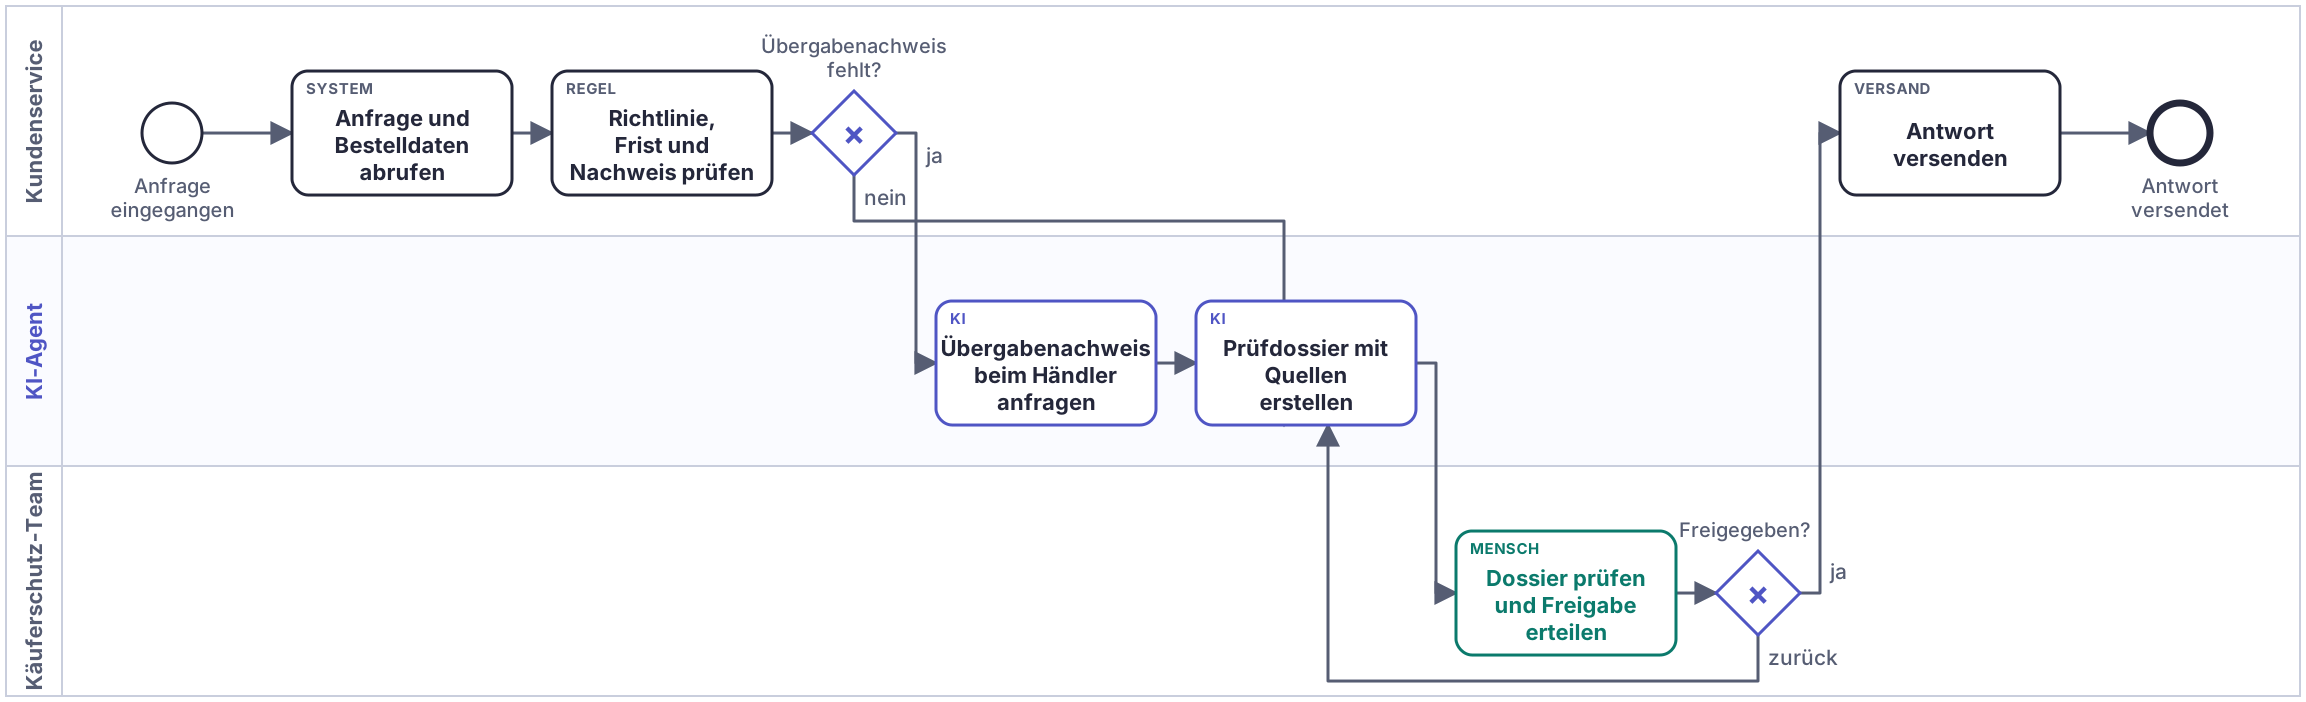
Nachher. Neu ist die mittlere Bahn „KI-Agent“. Davor bleiben Daten abrufen und Frist prüfen feste Schritte (ein Systemaufruf und eine Regel). Der Agent übernimmt nur dort, wo es keine eindeutige Antwort gibt. Die untere Bahn zeigt die Freigabe als Pflichtschritt. Der Pfeil „zurück“ führt bei einer Ablehnung wieder zum Agenten, versendet wird nur über den Pfeil „ja“.
Der Entwurf hat zwei Stärken: Die festen Schritte stehen vor den Schritten der KI, und nach außen geht nur, was das Käuferschutz-Team freigegeben hat.
Prüfung des Entwurfs
Der Entwurf wirkt auf den ersten Blick fertig. Eine genauere Prüfung zeigt drei Punkte.
Der Agent wählt keinen Weg. In der Bahn „KI-Agent“ stehen zwei Schritte in fester Reihenfolge: Nachweis beim Händler anfragen, Dossier erstellen. Ein Workflow und ein Agent unterscheiden sich darin, wer den nächsten Schritt bestimmt.
Beim Workflow ist der Ablauf vorgegeben, ein Sprachmodell erledigt darin einzelne Aufgaben. Beim Agenten sind Ziel und Grenzen vorgegeben, den Weg wählt das Sprachmodell selbst (Anthropic, Building effective agents). Nach dieser Unterscheidung ist der Entwurf ein Workflow mit zwei KI-Schritten. Er verbessert den alten Ablauf, enthält aber keinen Agenten im Sinne dieser Unterscheidung.
Eine Vorgabe ist verletzt. Die Vorgabe lautete: keine Nachricht versenden. Im Entwurf fragt der Agent trotzdem beim Händler an. Das kann sinnvoll sein. Diese Entscheidung muss aber das Käuferschutz-Team treffen, sie sollte nicht nebenbei in einem Entwurf fallen.
Die schwierigen Fälle bleiben ungelöst. Der neue Prozess beginnt wieder mit einem Datenabruf, der eine Bestellnummer erwartet. Für Anfragen ohne Bestellnummer enthält das Modell keinen Weg.
Die drei Punkte sprechen nicht gegen das Vorgehen. Der Entwurf macht Annahmen sichtbar, die das Prozessteam diskutieren kann.
Ein ähnliches Muster kenne ich aus Projekten: Ohne klare Vorgabe wird der Agent in den bestehenden Ablauf eingebaut. Das gilt offenbar auch, wenn eine KI den Ablauf entwirft.
Wann sich ein Agent lohnt
Ein Agent lohnt sich dort, wo erst ein Zwischenergebnis zeigt, was als Nächstes zu tun ist. Am Fall K-17 lässt sich das in zwei Runden zeigen.
- Runde 1 · WahrnehmenAnfrage lesenB-5521 fehlt, gemeldet am 25.09. Die Kundin bittet um Erstattung und beruft sich auf 30 Tage Meldefrist.
- Runde 1 · EntscheidenAktuelle Richtlinie holenNächste Aktion: die aktuelle Käuferschutz-Richtlinie prüfen. Nur die Version mit Status „aktuell“ darf eine Aussage stützen (Regel R1).
- Runde 1 · HandelnRichtlinie V3 lesenVersion 3 ist aktuell: 21 Tage, Fristende 22.09. Die Meldung vom 25.09. ist zu spät. Die zitierte Version 2 ist ersetzt.
- Runde 1 · PrüfenAbgleich: nicht fertigDie Frist allein entscheidet nicht über den Anspruch (R2). Offen ist, ob die Ware überhaupt angekommen ist. Also weiter.
- Runde 2 · WahrnehmenNeuer ZustandFrist nach Version 3 verpasst. Offen ist, ob B-5521 zugestellt wurde.
- Runde 2 · EntscheidenZustellung prüfenNächste Aktion: die Sendungsverfolgung zu B-5521 prüfen, statt sofort eine Absage zu entwerfen.
- Runde 2 · HandelnSendungsverfolgung lesenB-5521: „zugestellt (Paketshop)“. Übergabenachweis: „nicht dokumentiert“.
- Runde 2 · PrüfenGrenze erreicht: stoppenOhne Übergabenachweis gilt die Ware als ungeklärt, nicht als erhalten (R3). Der Agent stoppt und übergibt ein Dossier mit offenen Fragen an das Käuferschutz-Team (R5). Die Schleife endet bei erfülltem Auftrag, offener Frage oder definierter Grenze.
In der ersten Runde findet der Agent die aktuelle Richtlinie und stellt fest, dass die Frist abgelaufen ist. Die Frist allein entscheidet den Fall aber nicht. In der zweiten Runde prüft er deshalb die Sendungsverfolgung und stößt auf den fehlenden Übergabenachweis. An dieser Stelle stoppt er.
Das Käuferschutz-Team erhält ein Dossier mit folgenden Angaben, aber kein Urteil:
- Meldung drei Tage nach Fristende
- Paketshop meldet „zugestellt“
- Übergabenachweis fehlt
- offene Frage an den Händler
- zu jeder Aussage die Quelle
Dass nach der Fristprüfung die Sendungsverfolgung folgt, war vorher nirgends festgelegt. Der Schritt ergab sich aus dem Zwischenergebnis des Agenten. Zum Vergleich zeigt die folgende Abbildung den festen Ablauf mit drei Fällen:
Die drei Fälle als Text
- Anfrage erfassen: Bestellnummer genannt, Meldung innerhalb der Frist. Angenommener Standardfall.
- Bestelldaten abrufen: Bestelldaten gefunden. Richtlinie Version 3 (aktuell): 21 Tage Meldefrist.
- Gateway: Widerspruch zur Richtlinie?: Widerspruch? Nein. Die Meldung liegt innerhalb der Frist.
- Antwortentwurf erstellen (Sprachmodell): Entwurf mit Quelle Richtlinie Version 3.
- Prüfung und Freigabe Käuferschutz: Das Käuferschutz-Team prüft und gibt frei.
- Ende: Antwort versendet, durch den Kundenservice.
Der Normalfall läuft glatt durch. Dafür ist ein fester Workflow ideal: billig, schnell, prüfbar.
- Anfrage erfassen: B-5521 fehlt, Meldung am 25.09. Die Kundin zitiert 30 Tage (Version 2).
- Bestelldaten abrufen: Richtlinie Version 3 (aktuell): 21 Tage, Fristende 22.09. Tracking: „zugestellt (Paketshop)“.
- Gateway: Widerspruch zur Richtlinie?: Widerspruch? Ja. Die Meldung kommt 3 Tage nach Fristende.
- Rückfrage beim Händler: Der Kundenservice fragt von Hand beim Händler nach dem Übergabenachweis. 1 bis 2 Tage Wartezeit.
- Antwortentwurf erstellen (Sprachmodell): Entwurf auf Basis der Antwort des Händlers.
- Prüfung und Freigabe Käuferschutz: Das Käuferschutz-Team prüft und entscheidet.
- Ende: Antwort versendet, durch den Kundenservice.
Die Ausnahme ist behandelbar, weil der Pfad modelliert ist. Die eigentliche Recherche erledigt aber weiterhin der Kundenservice von Hand.
- Anfrage erfassen: „Ich habe bezahlt, aber nichts bekommen.“ Keine Bestellnummer. Angenommener Fall.
- Bestelldaten abrufen: Kein Treffer. Der Schritt erwartet eine Bestellnummer.
- Gateway: Widerspruch zur Richtlinie?: Die Regel hat kein Lieferdatum für die Frist. Der Fall rutscht in den Pfad, der am ehesten passt.
- Rückfrage beim Händler: Der Kundenservice sucht selbst die passende Bestellung. Diese Arbeit steht in keinem Prozessmodell.
- Antwortentwurf erstellen (Sprachmodell): Entwurf auf Basis dieser Recherche.
- Prüfung und Freigabe Käuferschutz: Das Käuferschutz-Team prüft und entscheidet.
- Ende: Antwort versendet, durch den Kundenservice.
Für diese Art von Ausnahme gibt es keinen Pfad. Jede neue Ausnahme braucht einen neuen Pfad oder jemanden, der sie von Hand bearbeitet. Genau hier wird ein Agent interessant.
Erläuterung:
- Der Standardfall läuft ohne Unterbrechung durch. Dafür ist ein fester Workflow gut geeignet, weil er günstig, schnell und prüfbar ist.
- K-17 funktioniert, weil der Pfad „Rückfrage beim Händler“ vorher modelliert wurde.
- Die Anfrage ohne Bestellnummer landet in dem Pfad, der am ehesten passt. Jemand im Kundenservice sucht die Bestellung dann von Hand.
Jeder dieser Fälle lässt sich nachmodellieren. Wenn sich die Recherche vorab vollständig aufzählen lässt, ist das auch der bessere Weg. Ein Agent lohnt sich erst, wenn immer neue Ausnahmen auftreten und jede Ausnahme einen weiteren Pfad oder Handarbeit bedeutet.
Feste Vorgaben im Prozessmodell
Wenn der Agent seinen Weg selbst wählt, muss geklärt sein, was trotzdem feststeht. Prozessplattformen bieten dafür inzwischen ein Muster, das festen Ablauf, Agent und Mensch in einem Modell verbindet.
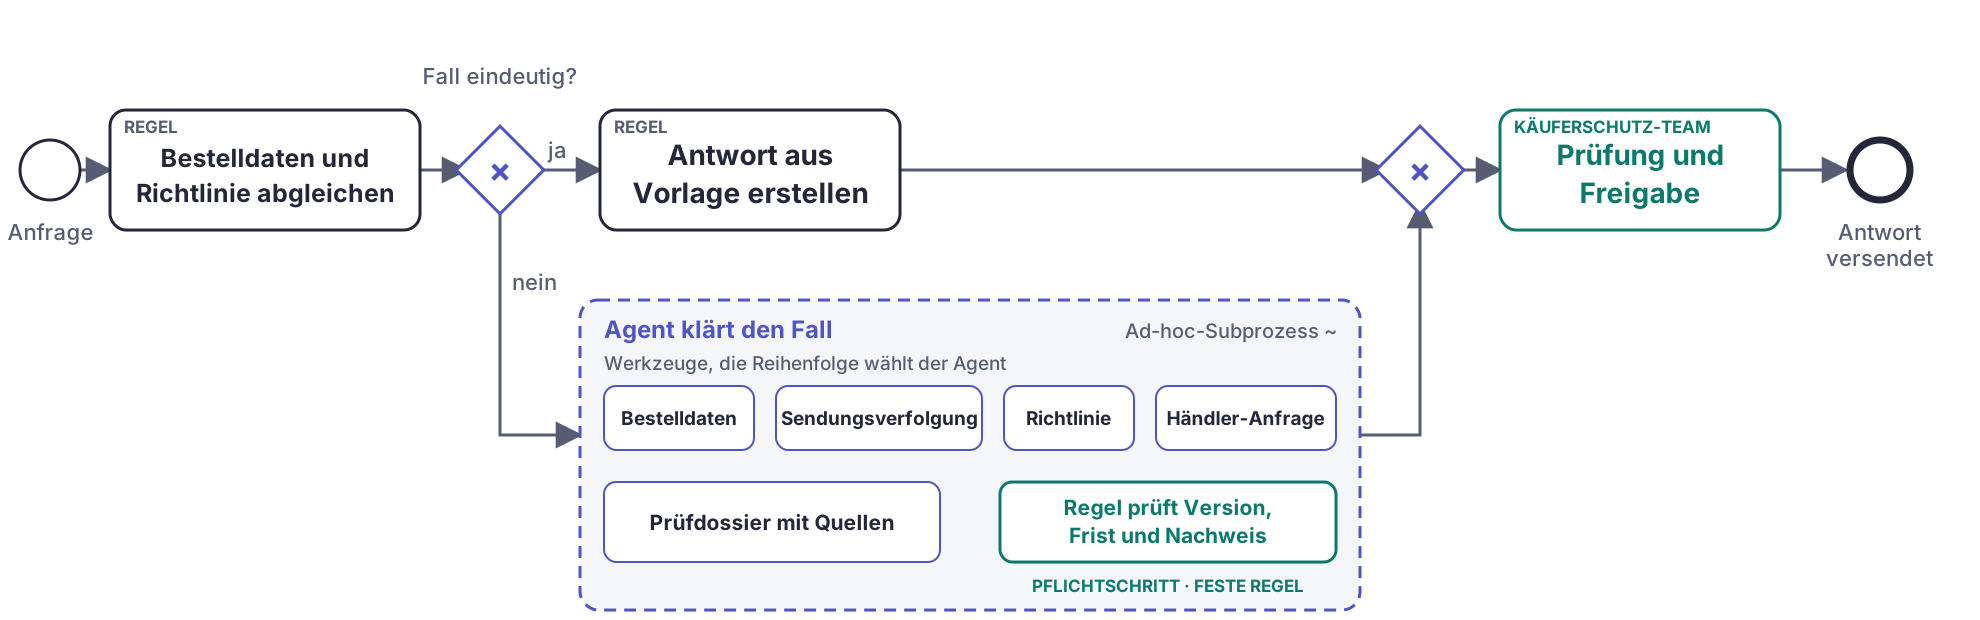
Oben verläuft der feste Pfad für eindeutige Fälle. Der gestrichelte Kasten darunter ist ein Ad-hoc-Subprozess: Dort wählt der Agent Werkzeuge und Reihenfolge selbst. Grün markiert sind die beiden Prüfstellen: die feste Regelprüfung im Subprozess und die Freigabe durch das Käuferschutz-Team. Sicher erzwungen ist in dieser Zeichnung nur die Freigabe, weil sie außerhalb des Kastens liegt (siehe Text). Muster nach Camunda 8.8 (Oktober 2025), AI Agent Sub-process. Eigene Darstellung für den Lehrfall.
Eindeutige Fälle laufen über den festen Pfad. Bei einem Widerspruch übernimmt der Agent und wählt im gestrichelten Kasten seine Werkzeuge selbst. Beide Pfade münden in dieselbe Freigabe durch das Käuferschutz-Team.
Begriff: Ad-hoc-Subprozess
Ein Ad-hoc-Subprozess ist ein BPMN-Element für Teilabläufe ohne feste Reihenfolge. Im Kasten liegen mehrere Aufgaben. Welche davon wann ausgeführt wird, entscheidet sich erst im Einzelfall. Prozessplattformen nutzen das Element, um Agenten einzubetten: Der Agent wählt die Werkzeuge im Kasten, der Prozess außen herum bleibt fest.
Eine Zeile im Prompt ist eine Bitte an das Sprachmodell.Ein verbindlich konfigurierter Schritt im Prozess wird durchgesetzt und protokolliert.
Wichtig ist dabei das Wort „verbindlich“. Die Zeichnung allein reicht dafür nicht aus: Schritte in einem Ad-hoc-Subprozess können mehrfach, in beliebiger Reihenfolge oder gar nicht ausgeführt werden (Camunda, Ad-hoc sub-processes). Für das Beispiel bedeutet das:
- Die Regelprüfung im Kasten ist erst dann Pflicht, wenn die Abschlussbedingung des Kastens sie voraussetzt oder wenn sie als fester Schritt dahinter steht.
- Die Freigabe ist erzwungen, weil sie außerhalb des Kastens liegt.
Pflichtschritte gehören deshalb nicht in den Kasten des Agenten.
Dasselbe gilt für die Regeln selbst. Welche Version der Richtlinie gilt und wann die Frist endet, ist im Lehrfall als feste, versionierte Regel hinterlegt, die das System ausführt. Im Prompt stehen diese Angaben nicht. In Prozessmodellen übernehmen das häufig Entscheidungstabellen nach dem Standard DMN.
KI-Agenten und Prozessmanagement
In der KI-Diskussion heißen diese Bausteine Guardrails, Human in the Loop, Eskalationspfad und Orchestrierung. Im Prozessmanagement heißen sie Gateway, Benutzeraufgabe, Entscheidungstabelle und Bahn. Dafür gibt es einen Standard, Werkzeuge und Fachleute, die seit Jahren damit arbeiten. Die Hersteller von Prozessplattformen betten Agenten inzwischen als Subprozess ein, und in der Forschung entsteht unter dem Namen „Agentic BPM“ ein eigenes Feld (Dumas et al. 2026, Calvanese et al. 2026).
Jedes Agenten-Vorhaben muss klären, wer entscheidet, was fest ist, wo der Weg offen bleiben darf und was protokolliert wird. Das sind Fragen des Prozessmanagements. Prozessteams können deshalb schon heute an einem eigenen Prozess festlegen, welcher Rahmen für einen Agenten gilt. Eine Agentenplattform ist dafür nicht erforderlich.
Ein Modell von Imas, Koh und Legg (Google DeepMind, Oktober 2026) ordnet diese Beobachtung ökonomisch ein. Es unterscheidet zwei Fähigkeiten eines Agenten (Mensch oder KI):
- Kompetenz: was der Agent allein kann.
- Koordination: wie gut er mit anderen zusammenarbeitet, Arbeit übergibt und Regeln einhält.
Benchmarks messen die Kompetenz. Über den Wert einer Organisation entscheidet nach dem Modell aber die Koordination. Die Autoren halten fest, dass Teams aus KI-Agenten in Benchmarks bisher an Fehlabstimmung und verlorenem Kontext scheitern und dass ihr Ergebnis mit der Zahl der Agenten nur unterproportional wächst.
Wer entscheidet, wer übergibt und wer prüft, ist Koordination. Prozessmodelle sind das Werkzeug, mit dem Organisationen diese Koordination festhalten. Das Paper beschreibt ein theoretisches Modell und ist keine Prognose.
Hinzu kommt eine Einschränkung: Der Rahmen im Prozess benötigt einen Rahmen im Unternehmen. Das zeigen Zahlen aus einer Befragung von 500 IT-Entscheidern deutscher Großunternehmen, die ich Anfang 2026 ausgewertet habe:
- 76 Prozent geben an, KI-Agenten zu erproben.
- 19 Prozent setzen KI-Agenten produktiv im Kerngeschäft ein.
- Von diesen 19 Prozent nennen 60 Prozent mindestens drei Governance-Strukturen. Bei den übrigen Unternehmen sind es 29 Prozent.
Begriff: Governance-Strukturen
Gemeint sind feste Regeln, Gremien und Rollen für den KI-Einsatz im Unternehmen. Dazu zählen zum Beispiel KI-Richtlinien, ein KI-Board, das über Vorhaben entscheidet, oder eine zentrale Führungsrolle für KI.
Die Befragung zeigt einen Zusammenhang. Sie belegt nicht, dass der Rahmen den produktiven Einsatz verursacht. Außerdem fragt sie nach Regeln und Gremien im Unternehmen und nicht nach Prozessmodellen, und sie umfasst nur Unternehmen ab 2.000 Mitarbeitenden.
Drei Hürden außerhalb des Prozessmodells
Die Befragung erfasst Regeln und Gremien. Drei weitere Hürden, an denen Agenten-Vorhaben in Unternehmen hängen bleiben, erfasst sie nicht. Alle drei lassen sich am Fall K-17 zeigen.
Der Engpass wandert. Joshua Gans und Avi Goldfarb beschreiben Arbeit als Kette, deren Ergebnis von der Qualität jedes Glieds abhängt (O-Ring Automation, nach dem O-Ring-Modell von Michael Kremer). Wird ein Schritt automatisiert, verschiebt sich die Zeit der Beteiligten auf die übrigen Schritte, und deren Wert ändert sich ebenfalls.
Ethan Mollick überträgt das in seinem Buch „Co-Existence“ auf Prozessketten zwischen Personen: Wird ein Schritt schneller, wandert der Engpass zum nächsten Schritt. Oft ist das eine Stelle, die vorher niemand beachtet hat. Die Rechnung „zehn Stunden Arbeit, zehn Minuten KI, eine Stunde Prüfen“ geht für Einzelne auf, in der Kette aus Review, Gremium und Kunde aber nicht.
Eine Telemetrie-Auswertung des Anbieters Faros AI über 10.000 Entwickler:innen in 1.255 Teams fand mit KI-Werkzeugen doppelt so viele Code-Änderungen, aber keine Verbesserung der Unternehmenskennzahlen. Mollick fasst das Muster sinngemäß so zusammen: Die einzelnen Entwickler waren schneller, der Sprint nicht.
Im Fall K-17 erstellt der Agent das Dossier in Minuten. Die Antwort des Händlers braucht weiter ein bis zwei Tage, und jedes Dossier landet beim Käuferschutz-Team. Erstellt der Agent zehnmal so viele Dossiers wie heute der Kundenservice, wird die Freigabe zum Engpass.
Wird ein Schritt schneller, wandert der Engpass zum nächsten.Die Messgröße für einen Piloten ist die Durchlaufzeit der Kette, vom Chat bis zur versendeten Antwort, nicht die Dauer des KI-Schritts.
Der gezeichnete Prozess ist nicht der gelebte. Das Whiteboard im ersten Versuch zeigt, wie eine Person den Prozess versteht. Ruthanne Huising hat Teams begleitet, die vor einem Redesign ihre Prozesse aufgenommen haben: 113 Interviews mit 48 Mitgliedern von sechs Teams in fünf Organisationen (Moving off the Map). Die Teams fanden Prozesse ohne Abnehmer, inoffizielle Wege und Doppelarbeit. Was als geplant und gesteuert galt, entstand laufend aus dem Zusammenspiel der Beteiligten, ohne dass jemand das Ganze überblickte.
Mollick nutzt dafür das Bild des Garbage Can aus der Organisationstheorie: Probleme, Lösungen und Beteiligte treffen lose aufeinander, und der Plan beschreibt davon nur einen Teil.
Im Fall K-17 ist die Anfrage ohne Bestellnummer ein solcher Weg. Jemand im Kundenservice sucht die Bestellung von Hand, auf dem Whiteboard steht davon nichts. Der Coding-Agent modelliert nur, was auf dem Foto steht. Die Prozessaufnahme mit den Menschen, die den Ablauf ausführen, muss deshalb vorher stattfinden. Die Notizdatei des Agenten mit seinen Annahmen ist dafür ein geeigneter Startpunkt.
Die Nutzung ist vorhanden, aber nicht sichtbar. Mollick berichtet, dass offizielle Chatbots in vielen Unternehmen rund 20 Prozent der Belegschaft erreichen, während über 40 Prozent angeben, KI bei der Arbeit zu nutzen (Making AI Work). Die Gründe für das Verstecken sind nachvollziehbar: Angst vor Strafe, Sorge um das Ansehen, Stellenabbau als Folge und höhere Erwartungen als neue Norm.
Für Prozessteams ist das praktisch relevant. Mitarbeitende, die im Kundenservice heute schon mit einem Chatbot nach der Bestellung suchen, wissen, wo die Ausnahmen liegen und welcher Prozess ein Kandidat ist. Damit sie ihre Nutzung offenlegen, muss sich das für sie lohnen. Dazu gehören:
- erlaubte Experimente
- Anerkennung für gefundene Anwendungsfälle
- die Zusage, Produktivitätsgewinne nicht automatisch in Stellenabbau zu übersetzen
Regeln und Gremien aus der Befragung sind damit nur ein Teil des Rahmens im Unternehmen. Die Anreize gehören ebenfalls dazu.
Alle drei Hürden kosten Zeit, bevor ein Effekt messbar ist. Erik Brynjolfsson, Daniel Rock und Chad Syverson beschreiben das als Produktivitäts-J-Kurve: Basistechnologien verlangen zuerst Investitionen in Prozesse, Rollen und Wissen, die in keiner Bilanz auftauchen. Der Nutzen zeigt sich erst später.
Für einen Piloten bedeutet das: In die Rechnung gehört neben den Minuten, die der Agent spart, auch die Zeit für Prozessaufnahme, Schulung und Nacharbeit.
Offene Fragen
Zeitersparnis durch den neuen Prozess. Der Entwurf ist eine Gestaltungshypothese. Die Wartezeit auf den Händler bleibt in jedem Fall bestehen, und der Engpass kann zur Freigabe wandern. Ein Pilot müsste deshalb messen:
- wie sich die Durchlaufzeit verändert
- wie oft das Käuferschutz-Team ein Dossier zurückgibt
- wie viel Nacharbeit entsteht
- was der Betrieb kostet
Eine Befragung der Beteiligten reicht dafür nicht aus. In einem randomisierten Experiment von METR mit 16 erfahrenen Open-Source-Entwickler:innen und 246 Aufgaben brauchten die Teilnehmenden mit KI-Werkzeugen 19 Prozent länger (Becker et al. 2025). Vorher erwarteten sie 24 Prozent Zeitersparnis, nach dem Experiment schätzten sie immer noch 20 Prozent.
Die Stichprobe ist klein, die Aufgaben stammen aus reifen Projekten mit hohen Standards, und die Werkzeuge sind auf dem Stand von Anfang 2025. Das Experiment zeigt aber, dass gefühlte und gemessene Produktivität auseinandergehen können. Ein Pilot sollte deshalb die Durchlaufzeit messen.
Der Fall Klarna. Anfang 2024 stellte der Zahlungsdienst einen KI-Assistenten in den Kundenservice-Chat. Nach eigenen Angaben übernahm er im ersten Monat zwei Drittel der Chats (Klarna, Pressemitteilung vom 27.02.2024). Im Mai 2025 räumte CEO Sebastian Siemiatkowski im Gespräch mit Bloomberg sinngemäß ein, dass Kosten ein zu dominantes Kriterium gewesen seien und die Qualität gelitten habe. Das Unternehmen stellt wieder Menschen im Service ein.
Der Fall wird für zwei gegensätzliche Aussagen herangezogen: dass Agenten den Service übernehmen können, und dass sie es nicht können. Aus den öffentlichen Quellen geht nicht hervor, was im Prozess genau fehlte. Der Lehrfall in diesem Beitrag hat mit Klarna nichts zu tun.
Haltbarkeit der Einschätzung. Agenten bewältigen immer längere Aufgaben (siehe Messungen im Anhang). Was heute als Grenze eines Agenten gilt, kann in einem Jahr überholt sein. Der Rahmen aus Zuständigkeit, festen Regeln und Freigabe hängt davon nicht ab.
Vorgehen für einen eigenen Prozess
Die beiden Versuche lassen sich mit einem eigenen Prozess wiederholen. Dafür sind vier Schritte nötig, eine neue Plattform ist nicht erforderlich.
1. Einen Kandidaten wählen. Geeignet ist ein Prozess, wenn mehrere dieser Merkmale zutreffen:
- Ausnahmen landen bei Menschen, die bei null anfangen.
- Die Antwort steckt in mehreren Quellen (im Lehrfall: Chat, Bestelldaten, Richtlinie).
- Es gibt eine benannte Stelle, die entscheidet.
- Fehler lassen sich abfangen, bevor sie nach außen wirken. Ein Prozess, in dem der Agent sofort buchen oder versenden müsste, ist kein Startkandidat.
- Der Fall kommt oft genug vor, dass sich ein Pilot auswerten lässt.
2. Die Vorgaben aufschreiben. Auf eine Seite gehört, was der Coding-Agent nicht selbst wissen kann:
- wer entscheidet (eine Rolle, keine Person)
- was der Agent nie darf
- ob der Agent nach außen wirken darf, bspw. bei Dritten nachfragen
- welche Regeln fest sind
- welches Wissen der Prozess benötigt
3. Den Entwurf beauftragen. Der Coding-Agent bekommt das Foto oder eine Beschreibung des heutigen Ablaufs, die Vorgaben und eine Arbeitsanweisung. Die Arbeitsanweisung aus dem Lehrfall steht hier in einer allgemeinen Fassung bereit:
4. Den Entwurf mit der Fachabteilung prüfen. Sechs Fragen genügen für den ersten Durchgang:
- Liegt jeder Schritt in der Bahn der Rolle, die ihn wirklich ausführt?
- Wo wählt der Agent seinen Weg selbst, und wo sind seine Schritte fest vorgegeben?
- Ist jede Wirkung nach außen (Versand, Zahlung, Anfrage an Dritte) entweder freigegeben oder ausdrücklich erlaubt?
- Was passiert bei einer Ablehnung, und wann endet die Schleife?
- Welche Annahmen hat der Agent in seinen Notizen festgehalten, und welche davon stimmen nicht?
- Welche Wege nimmt der Fall heute, die im Modell nicht stehen, und wer geht sie?
Die größten Schwierigkeiten entstehen meist zwischen Workshop und Betrieb, wenn Berechtigungen, Datenzugriffe und Netzwerk geklärt werden müssen. Wenn Architektur und Data Science schon am Entwurf beteiligt sind, lassen sich diese Fragen klären, bevor sie den Piloten aufhalten.
In einem Workshop können ein geeigneter Prozess, ein prüfbarer Entwurf und die Messgrößen für einen Piloten gemeinsam erarbeitet werden.
Anhang: Zeithorizont von KI-Agenten
KI-Agenten bewältigen immer längere Aufgaben. Die Forschungsorganisation METR misst, wie lange ein Mensch für eine Software-Aufgabe braucht, die ein Sprachmodell in der Hälfte der Fälle löst. Bei GPT-4 vom März 2023 lag dieser Wert bei rund vier Minuten, bei Claude Opus 4.6 vom Februar 2026 bei rund zwölf Stunden (METR, Time Horizons).
- bei Erscheinen der höchste gemessene Wert
- weitere Modelle
Alle Werte als Tabelle
| Modell | Erschienen | Zeithorizont | Spanne |
|---|---|---|---|
| GPT-2 | Februar 2019 | 3 Sekunden | 1 Sekunden bis 8 Sekunden |
| davinci-002 (GPT-3) | Mai 2020 | 8 Sekunden | 5 Sekunden bis 13 Sekunden |
| GPT-3.5 Turbo Instruct | März 2022 | 36 Sekunden | 16 Sekunden bis 1 Minuten |
| GPT-4 | März 2023 | 4 Minuten | 2 Minuten bis 8 Minuten |
| GPT-4 (Nov. 2023) | November 2023 | 4 Minuten | 2 Minuten bis 8 Minuten |
| Claude 3 Opus | März 2024 | 4 Minuten | 2 Minuten bis 9 Minuten |
| GPT-4 Turbo | April 2024 | 4 Minuten | 2 Minuten bis 7 Minuten |
| GPT-4o | Mai 2024 | 7 Minuten | 4 Minuten bis 13 Minuten |
| Claude 3.5 Sonnet (Juni 2024) | Juni 2024 | 11 Minuten | 5 Minuten bis 22 Minuten |
| o1-preview | September 2024 | 20 Minuten | 12 Minuten bis 33 Minuten |
| Claude 3.5 Sonnet (Okt. 2024) | Oktober 2024 | 21 Minuten | 10 Minuten bis 41 Minuten |
| o1 | Dezember 2024 | 39 Minuten | 21 Minuten bis 65 Minuten |
| Claude 3.7 Sonnet | Februar 2025 | 60 Minuten | 33 Minuten bis 1,7 Stunden |
| o3 | April 2025 | 2,0 Stunden | 75 Minuten bis 3,2 Stunden |
| Claude Opus 4 | Mai 2025 | 1,7 Stunden | 60 Minuten bis 2,7 Stunden |
| Claude Opus 4.1 | August 2025 | 1,7 Stunden | 59 Minuten bis 2,7 Stunden |
| GPT-5 | August 2025 | 3,4 Stunden | 1,9 Stunden bis 6,8 Stunden |
| Gemini 3 Pro | November 2025 | 3,7 Stunden | 2,3 Stunden bis 6,3 Stunden |
| GPT-5.1-Codex-Max | November 2025 | 3,7 Stunden | 2,2 Stunden bis 6,6 Stunden |
| Claude Opus 4.5 | November 2025 | 4,9 Stunden | 2,7 Stunden bis 10,4 Stunden |
| GPT-5.2 | Dezember 2025 | 5,9 Stunden | 3,3 Stunden bis 13,6 Stunden |
| Claude Opus 4.6 | Februar 2026 | 12,0 Stunden | 5,3 Stunden bis 60,6 Stunden |
| GPT-5.3-Codex | Februar 2026 | 5,8 Stunden | 3,2 Stunden bis 13,6 Stunden |
| Gemini 3.1 Pro | Februar 2026 | 6,4 Stunden | 3,9 Stunden bis 11,6 Stunden |
| GPT-5.4 | März 2026 | 5,7 Stunden | 3,1 Stunden bis 12,8 Stunden |
| Claude Mythos Preview | April 2026 | 17,4 Stunden | 8,5 Stunden bis 55,1 Stunden |
Gemessen wird an Software-Aufgaben und bei 50 Prozent Erfolgsquote. Die Werte lassen sich daher nicht auf jede Büroarbeit übertragen. Wichtiger als der einzelne Wert ist die Entwicklung: Seit 2023 verdoppelt sich der Zeithorizont nach den Daten von METR etwa alle vier Monate.
Verdopplungen werden leicht unterschätzt, weil die Werte lange klein bleiben. Ein Vergleich: Wer mit einem Schritt von 75 Zentimetern losgeht und jeden weiteren Schritt doppelt so lang macht wie den vorigen, ist nach 29 Schritten am Mond. Nach 20 Schritten sind aber erst 786 Kilometer geschafft, das sind 0,2 Prozent der Strecke. Mit gleich langen Schritten wären rund 500 Millionen Schritte nötig.
Der erste Schritt misst 75 Zentimeter. Bis zum Mond sind es 384.400 Kilometer.
| Schritt | Länge des Schritts | Zurückgelegt | Anteil der Strecke |
|---|---|---|---|
| 1 | 75 cm | 75 cm | unter 0,1 % |
| 2 | 1,5 m | 2,3 m | unter 0,1 % |
| 3 | 3,0 m | 5,3 m | unter 0,1 % |
| 5 | 12 m | 23 m | unter 0,1 % |
| 10 | 384 m | 767 m | unter 0,1 % |
| 15 | 12,3 km | 24,6 km | unter 0,1 % |
| 20 | 393 km | 786 km | 0,2 % |
| 25 | 12.583 km | 25.166 km | 6,5 % |
| 26 | 25.166 km | 50.332 km | 13 % |
| 27 | 50.332 km | 100.663 km | 26 % |
| 28 | 100.663 km | 201.327 km | 52 % |
| 29 | 201.327 km | 402.653 km | 100 % |
Ob das Tempo anhält, ist offen. Für die Prozessgestaltung ist die Richtung wichtig: Ein Prozessentwurf sollte nicht davon ausgehen, dass Agenten auf dem heutigen Stand bleiben.
Quellen und Hinweise
- Lehrfall K-17: Alle Namen, Bestellungen, Richtlinien, Zeiten und Modelle sind erfunden.
- Aufgezeichnete Läufe: Die Mitschrift des Coding-Agenten und der Dateiausschnitt stammen aus vorab aufgezeichneten Läufen, die Wiedergabe ist beschleunigt. Sie zeigen, wie die Dateien im Lehrfall entstanden sind, und sind kein Leistungsversprechen für andere Prozesse.
- Whiteboard-Foto: Das Foto der Skizze ist synthetisch und wurde mit KI erzeugt. Alle übrigen Abbildungen sind eigene Zeichnungen.
- Kirenz (2026): Generative KI in deutschen Großunternehmen. Befragung von 500 IT-Entscheidern aus Unternehmen ab 2.000 Mitarbeitenden, Civey im Auftrag von Zoi, Januar 2026. Selbstauskunft.
- Anthropic (2024): Building effective agents. Praxisleitfaden.
- METR (2026): Time Horizons, Time Horizon 1.1. Messung an Software-Aufgaben. Die Abbildung ist eine eigene Darstellung aus den dort veröffentlichten Daten.
- Klarna (2024): Pressemitteilung zum KI-Assistenten, 27.02.2024. Selbstauskunft.
- Bloomberg (2025): Klarna turns from AI to real person customer service, 08.05.2025.
- Camunda: AI agents. Dokumentation zum Agenten als Ad-hoc-Subprozess. Dazu Ad-hoc sub-processes, Version 8.8.
- Dumas, Milani und Chapela-Campa (2026): Agentic Business Process Management Systems. Positionspapier.
- Calvanese et al. (2026): Agentic Business Process Management: A Research Manifesto. Forschungsagenda.
- Imas, Koh und Legg (2026): Organizing Intelligence, Google DeepMind, Working Paper, Oktober 2026. Theoretisches Modell zu Kompetenz und Koordination in Organisationen.
- Mollick (2026): Co-Existence. The Next Phase of AI. Kapitel zu Organisationen (O-Ring-Ketten, Garbage Can, Leadership, Crowd und Lab). Zitate sinngemäß übersetzt.
- Mollick (2025): Making AI Work: Leadership, Lab, and Crowd, One Useful Thing, Mai 2025. Quelle der Angaben zur offiziellen und tatsächlichen KI-Nutzung.
- Gans und Goldfarb (2026): O-Ring Automation, NBER Working Paper 34639, Januar 2026. Nicht begutachtet.
- Huising (2019): Moving off the Map: How Knowledge of Organizational Operations Empowers and Alienates, Organization Science 30(5). Interviewstudie zum Prozess-Mapping vor Redesigns.
- Cohen, March und Olsen (1972): A Garbage Can Model of Organizational Choice, Administrative Science Quarterly 17(1).
- Faros AI (2025): AI Productivity Paradox: Why Engineering Performance Stalled. Herstellerreport, Zahlen aus der Zusammenfassung der Anbieterseite.
- Becker, Rush, Barnes und Rein (2025): Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, METR. Randomisiertes Experiment.
- Brynjolfsson, Rock und Syverson (2021): The Productivity J-Curve: How Intangibles Complement General Purpose Technologies, American Economic Journal: Macroeconomics 13(1).